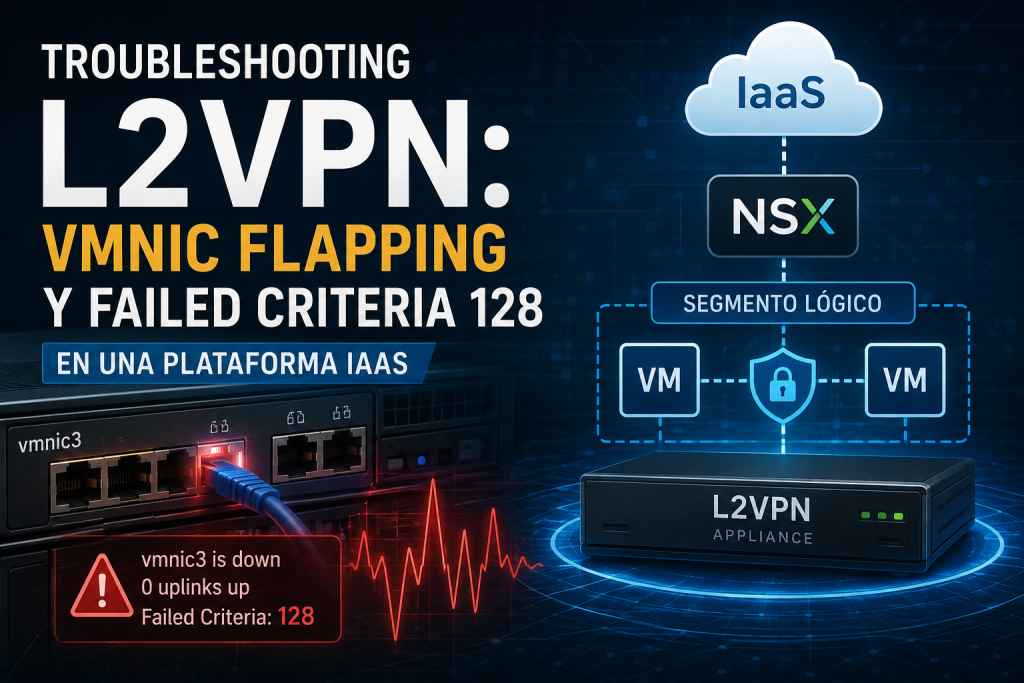
Hola, en este nuevo post vamos a revisar un caso bastante interesante de troubleshooting de red en una plataforma IaaS, donde el requerimiento inicial parecía sencillo: extender una red de capa 2 mediante un túnel L2VPN.
Sin embargo, al habilitar el tráfico comenzaron a presentarse eventos de flapping sobre una vmnic de los hosts ESXi, afectando la conectividad.
Lo interesante de este caso es que el problema inicialmente podía apuntar a varias capas: driver, firmware, SFP+, cableado, switch físico o incluso a la forma en que estaba circulando el tráfico dentro de la infraestructura virtual.
Vamos a revisar cómo se identificó el problema y qué solución permitió estabilizar el ambiente.
Escenario
La plataforma IaaS utilizaba una arquitectura de red definida por software mediante NSX, donde las redes de organización de los clientes estaban soportadas mediante segmentación lógica.
El requerimiento consistía en establecer una L2VPN utilizando una herramienta de terceros para extender una red entre la nube y la infraestructura on-premises del cliente.
En este caso particular, la herramienta utilizada para realizar el túnel requería habilitar las siguientes políticas de seguridad:
- Promiscuous Mode
- MAC Address Changes
- Forged Transmits
El inconveniente era que estas configuraciones no podían aplicarse directamente sobre la red lógica utilizada por el cliente.
Por esta razón fue necesario buscar un workaround.
Aparece el flapping de la vmnic
Al generar tráfico sobre la red extendida se observó que la interfaz física utilizada por los hosts ESXi comenzaba a presentar cambios de estado.
Revisando los logs apareció un evento similar al siguiente:
[netCorrelator]
[vob.net.dvport.uplink.transition.down]
Uplink: vmnic3 is down.
0 uplinks up.
Failed criteria: 128
El dato importante aquí era:
Failed criteria: 128Cuando encontramos este tipo de eventos no es recomendable asumir inmediatamente que el problema está en VMware.
Tenemos que revisar toda la ruta del tráfico.
¿Qué significa Failed Criteria 128?
De acuerdo con el KB oficial de Broadcom Network adapter (vmnic) is down or fails with a Failed Criteria Code, el código:
128significa:
Link state reported by the driverEs decir, el driver está reportando que el estado del enlace físico está DOWN.
Broadcom también indica que, cuando esta caída no ha sido provocada intencionalmente, se deben revisar diferentes componentes de la infraestructura, entre ellos:
- Driver de la NIC.
- Firmware.
- Módulo SFP+.
- Cableado.
- Switchport del switch físico.
Este punto es importante porque el log por sí solo muestra el efecto observado por ESXi, pero no necesariamente identifica directamente la causa raíz.
Para mayor información: https://knowledge.broadcom.com/external/article/318898/network-adapter-vmnic-is-down-or-fails-w.html
Primeras validaciones
Una de las primeras verificaciones que podemos realizar desde ESXi es revisar el estado de las interfaces físicas.
Podemos utilizar:
esxcli network nic listEste comando nos permite visualizar información como:
Name
Driver
Link Status
Speed
Duplex
MAC Address
MTU
Description
Si necesitamos revisar una interfaz específica con mayor detalle podemos ejecutar:
esxcli network nic get -n vmnic#Por ejemplo:
esxcli network nic get -n vmnic3Aquí podemos obtener datos importantes como:
Driver
Firmware Version
Driver Version
Link Status
Bus Info
Con esta información podemos comenzar a comparar el estado actual del hardware con las versiones compatibles para nuestra versión de ESXi.
Validación de driver y firmware
Otro de los KB utilizados durante el análisis fue Determining Network/Storage firmware and driver version in ESXi.
Broadcom recomienda identificar correctamente la tarjeta utilizando los valores:
- VID — Vendor ID.
- DID — Device ID.
- SVID — Sub-Vendor ID.
- SDID — Sub-Device ID.
Para obtener esta información podemos utilizar:
vmkchdev -l | grep vmnicTambién es importante identificar exactamente la versión del host ESXi:
vmware -vlCon esta información podemos realizar la validación correspondiente en el Broadcom Compatibility Guide: https://knowledge.broadcom.com/external/article/323110/determining-networkstorage-firmware-and.html
Este paso es importante.
Antes de modificar configuraciones de red o reemplazar componentes físicos conviene confirmar que la combinación entre:
ESXi + driver + firmware + adaptador físico
sea compatible.
Entonces, ¿qué estaba sucediendo?
Después de realizar las verificaciones con VMware/Broadcom y con la contraparte responsable de los servidores físicos, se encontró un comportamiento importante dentro del flujo de red.
El tráfico proveniente de la red de vApp de organización utilizado para el L2 extendido estaba regresando hacia la NIC física del servidor.
Esto generaba un comportamiento de bucle sobre la red.
Como consecuencia, la interfaz física utilizada por el perfil de red del servidor terminaba perdiendo conectividad.
Aquí estaba realmente el punto crítico del caso.
No se trataba simplemente de observar:
Failed criteria: 128y reemplazar una NIC.
Había que entender qué estaba provocando que el enlace terminara reportándose como DOWN.
Solución aplicada
La solución fue crear un portgroup ad-hoc destinado específicamente al tráfico del túnel.
El objetivo era evitar que el tráfico generado por la red de vApp de organización pudiera salir hacia el entorno físico y regresar nuevamente hacia la interfaz del servidor.
Una consideración importante: afinidad
El workaround resolvía el requerimiento, pero introducía una consideración operativa.
Las máquinas virtuales que utilizaban esta red debían permanecer dentro del mismo host ESXi.
Por esta razón fue necesario utilizar reglas de afinidad.
Si una de estas VMs cambiaba de host, podía perder conectividad con la red utilizada para el L2 extendido.
Esto significa que el workaround era funcional, pero también introducía una dependencia con la ubicación de las máquinas virtuales dentro del clúster.
Y este es precisamente uno de esos puntos que debemos analizar antes de considerar un workaround como una solución definitiva.
¿Qué podemos aprender de este caso?
Una de las cosas más importantes durante un troubleshooting de red en virtualización es no quedarse únicamente con el primer mensaje de error.
Cuando observamos algo como:
vmnic down
Failed criteria: 128
podríamos pensar inmediatamente en:
NIC
Driver
Firmware
SFP
Cable
Switch
y efectivamente todos esos componentes deben ser revisados.
Pero también tenemos que analizar:
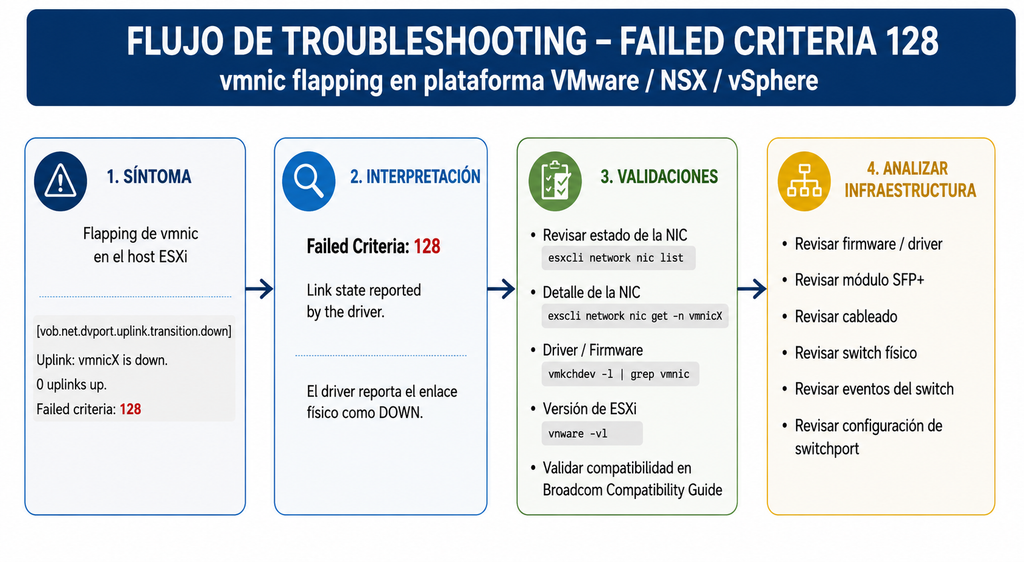
En ambientes donde tenemos Cloud Director + NSX + vSphere Networking + networking físico, el troubleshooting debe realizarse de extremo a extremo.
La frontera entre la red virtual y la física es precisamente donde muchos problemas pueden volverse difíciles de identificar.
Recomendaciones
Después de analizar este caso, considero importantes los siguientes puntos:
1. Revisar siempre los logs antes de realizar cambios.
En este caso vobd.log permitió identificar el evento sobre la vmnic y el código asociado.
2. No interpretar Failed Criteria 128 como una causa raíz automática.
El código nos indica que el driver reportó el enlace como DOWN. A partir de allí debemos determinar qué provocó ese cambio.
3. Validar driver y firmware.
Utilizar las herramientas de ESXi y el Broadcom Compatibility Guide para comprobar la combinación instalada.
4. Revisar también la infraestructura física.
SFP+, cableado, switchport y eventos registrados por el switch deben formar parte del troubleshooting.
5. Entender completamente el flujo de tráfico.
En este caso, seguir el recorrido del tráfico permitió identificar que este estaba regresando hacia la NIC del servidor.
6. Documentar las limitaciones de cualquier workaround.
Si una solución requiere reglas de afinidad y evita que ciertas máquinas virtuales puedan moverse libremente entre hosts, esa condición debe quedar claramente documentada.
7. Evaluar alternativas nativas para L2VPN.
Cuando sea posible, conviene evaluar mecanismos que eviten depender de configuraciones como Promiscuous Mode, Forged Transmits y MAC Address Changes. Para este ambiente, una de las recomendaciones del análisis fue evaluar la funcionalidad de L2VPN mediante NSX.
Conclusión
Este caso comenzó como un requerimiento para extender una red mediante L2VPN y terminó convirtiéndose en un interesante troubleshooting entre networking virtual y networking físico.
El evento:
Failed criteria: 128fue una pista importante, pero no era suficiente para determinar por sí solo la causa del problema.
La revisión completa del flujo permitió identificar que el tráfico del L2 extendido estaba interactuando con la red física de una forma que terminaba afectando el uplink del servidor.
Finalmente, el uso de un portgroup específico para aislar este tráfico permitió estabilizar la solución, considerando adicionalmente las restricciones de afinidad requeridas por las máquinas virtuales.
Como siempre, en virtualización no todo problema que aparece en ESXi necesariamente comienza en ESXi.
A veces hay que seguir el paquete.!!